最近一段时间,刷到了"豆包喂养"这样的一个新词。
我一开始也以为它是那种"把豆包养成另一个自己"的玩法。真去查了一圈才发现,说的是字节这些大厂招真人去录语音、做标注,给大模型"造数据"这类活。而这些活,基本都挂在字节自己搭的一个平台下面:「模兜」。
「模兜」:这些活儿的大本营
模兜到底是个什么平台
模兜是字节跳动旗下的 AI 数据众包与专家服务平台,官网 modoudance.com(这套业务以前还用过 竹节、闲包包 两个名字)。它一头连着要高质量语料的豆包等大模型,一头连着有专业背景、想接单变现的人。
上面都在招些什么活
模兜上的活,早就不是传统那种拉框打标了,更像在"教 AI 说话、做判断"。我扒了下平台在招的任务,大致落在四类:
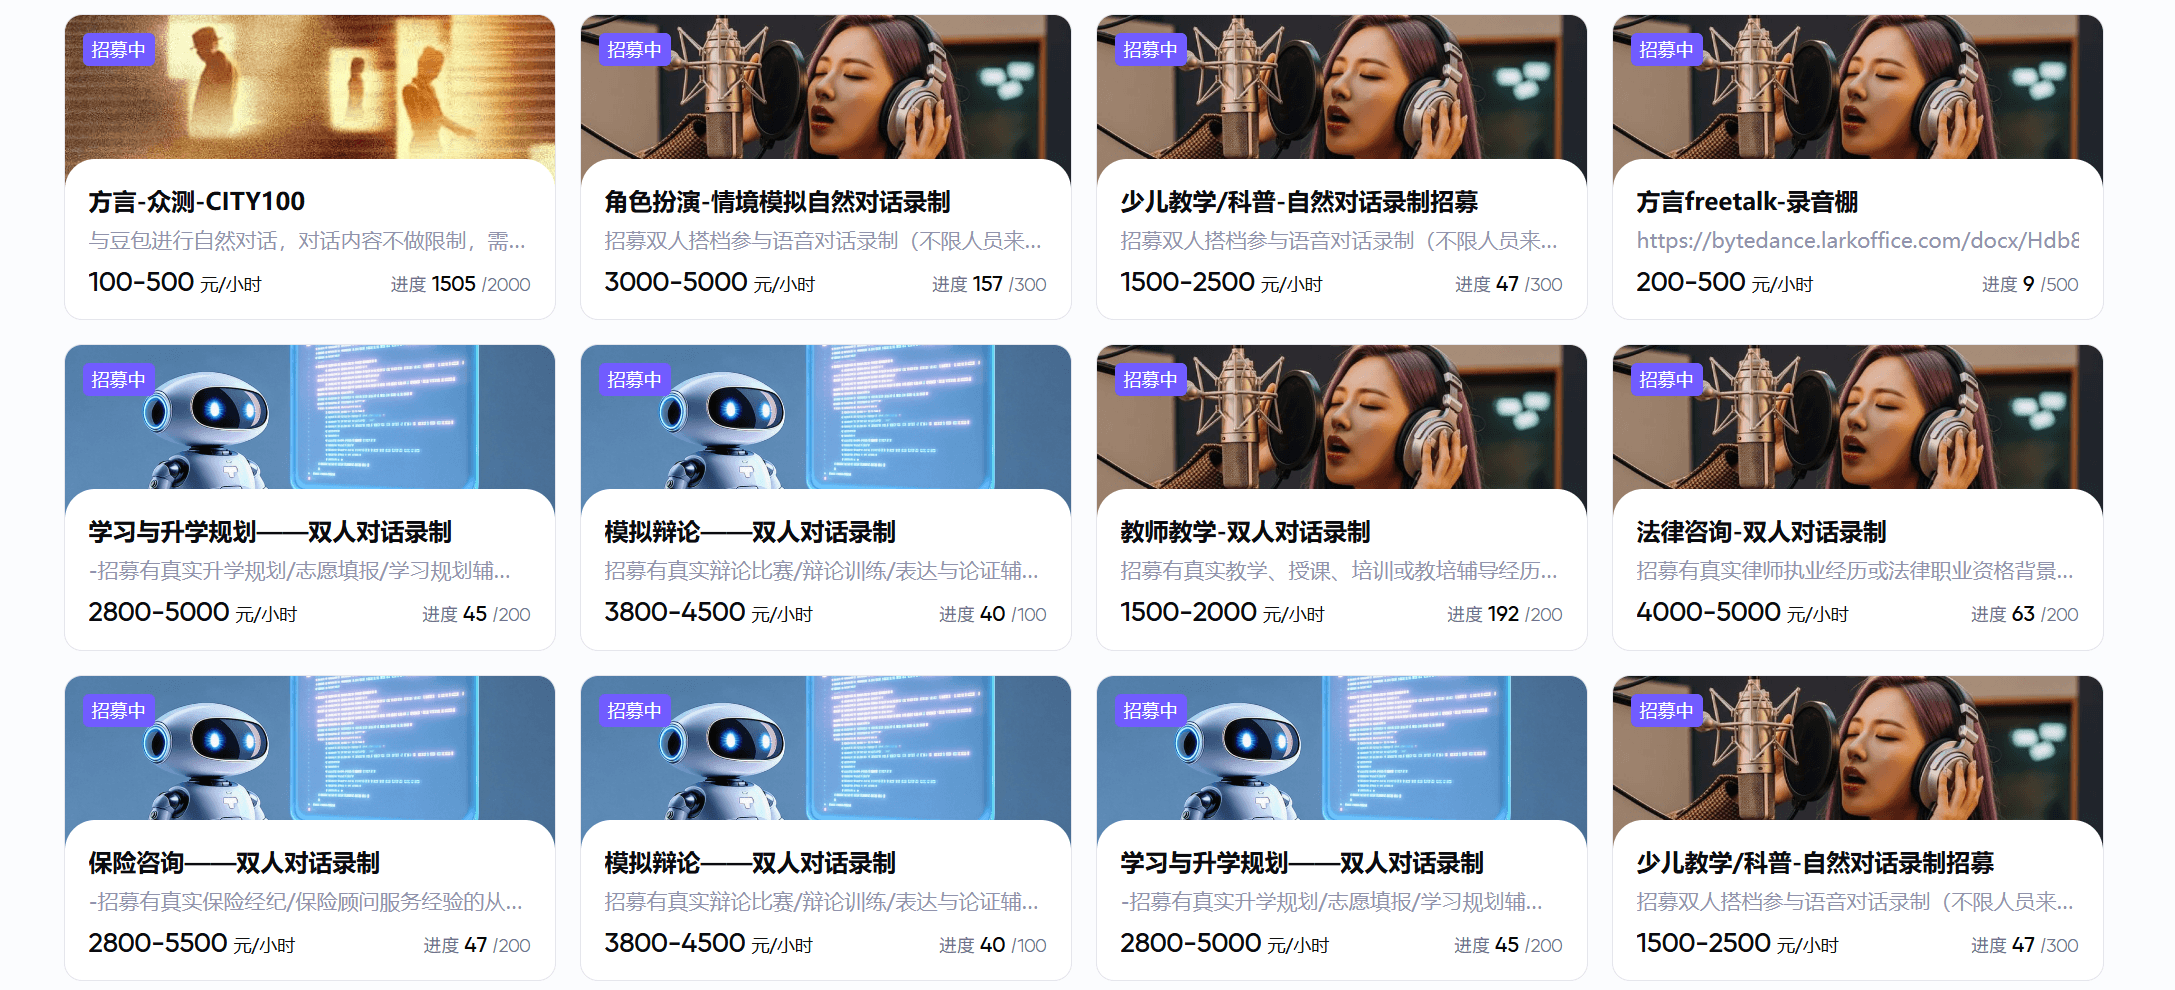
- 语音 / 对话录制:数量最多、单价也最高。招双人搭档进线下录音棚,围绕一个专业场景自然对话:教师教学、少儿教学/科普、升学规划、模拟辩论、法律咨询、角色扮演情境模拟都有,单价 1500–5000 元;方言双人 FreeTalk、方言录音棚也算这一类。
- 方言与语音数据:方言数据整理(三亚、怀化、玉林、江门等片区)、方言众测、豆包方言体验调研、豆包通话打卡,单价几十到几百。
- 专业评测:给 AI 生成的音乐打分(旋律、和声、编曲、原创性等维度),还有医疗领域的医生评估校验。
- 数据采购:像 3D 动捕数据采购,给
T2M(text-to-motion)模型备料。
一个真实的任务长什么样
光说类型有点干,直接看个真挂出来的单子更清楚。我在模兜上翻到一个还在招募的《少儿教学/科普-自然对话录制》:
- 招双人搭档去录,一个演"老师/引导者",一个演"学生/陪聊",内容是少儿教学、科普场景下的自然对话;要求真实自然,别照稿念、别尬演;
- 线下实体录音棚录制,全国主要城市都有棚,总时长 4 小时,每人最多录一场;
- 单价 1500–2500 元;有试音环节,录用周期大约 1 天;
- 人员画像上,“老师"那位最好有少儿教育、科普、亲子、教培或兴趣教学的底子;“陪聊"那位则要真学生、真小孩,或者声音特别像孩子。
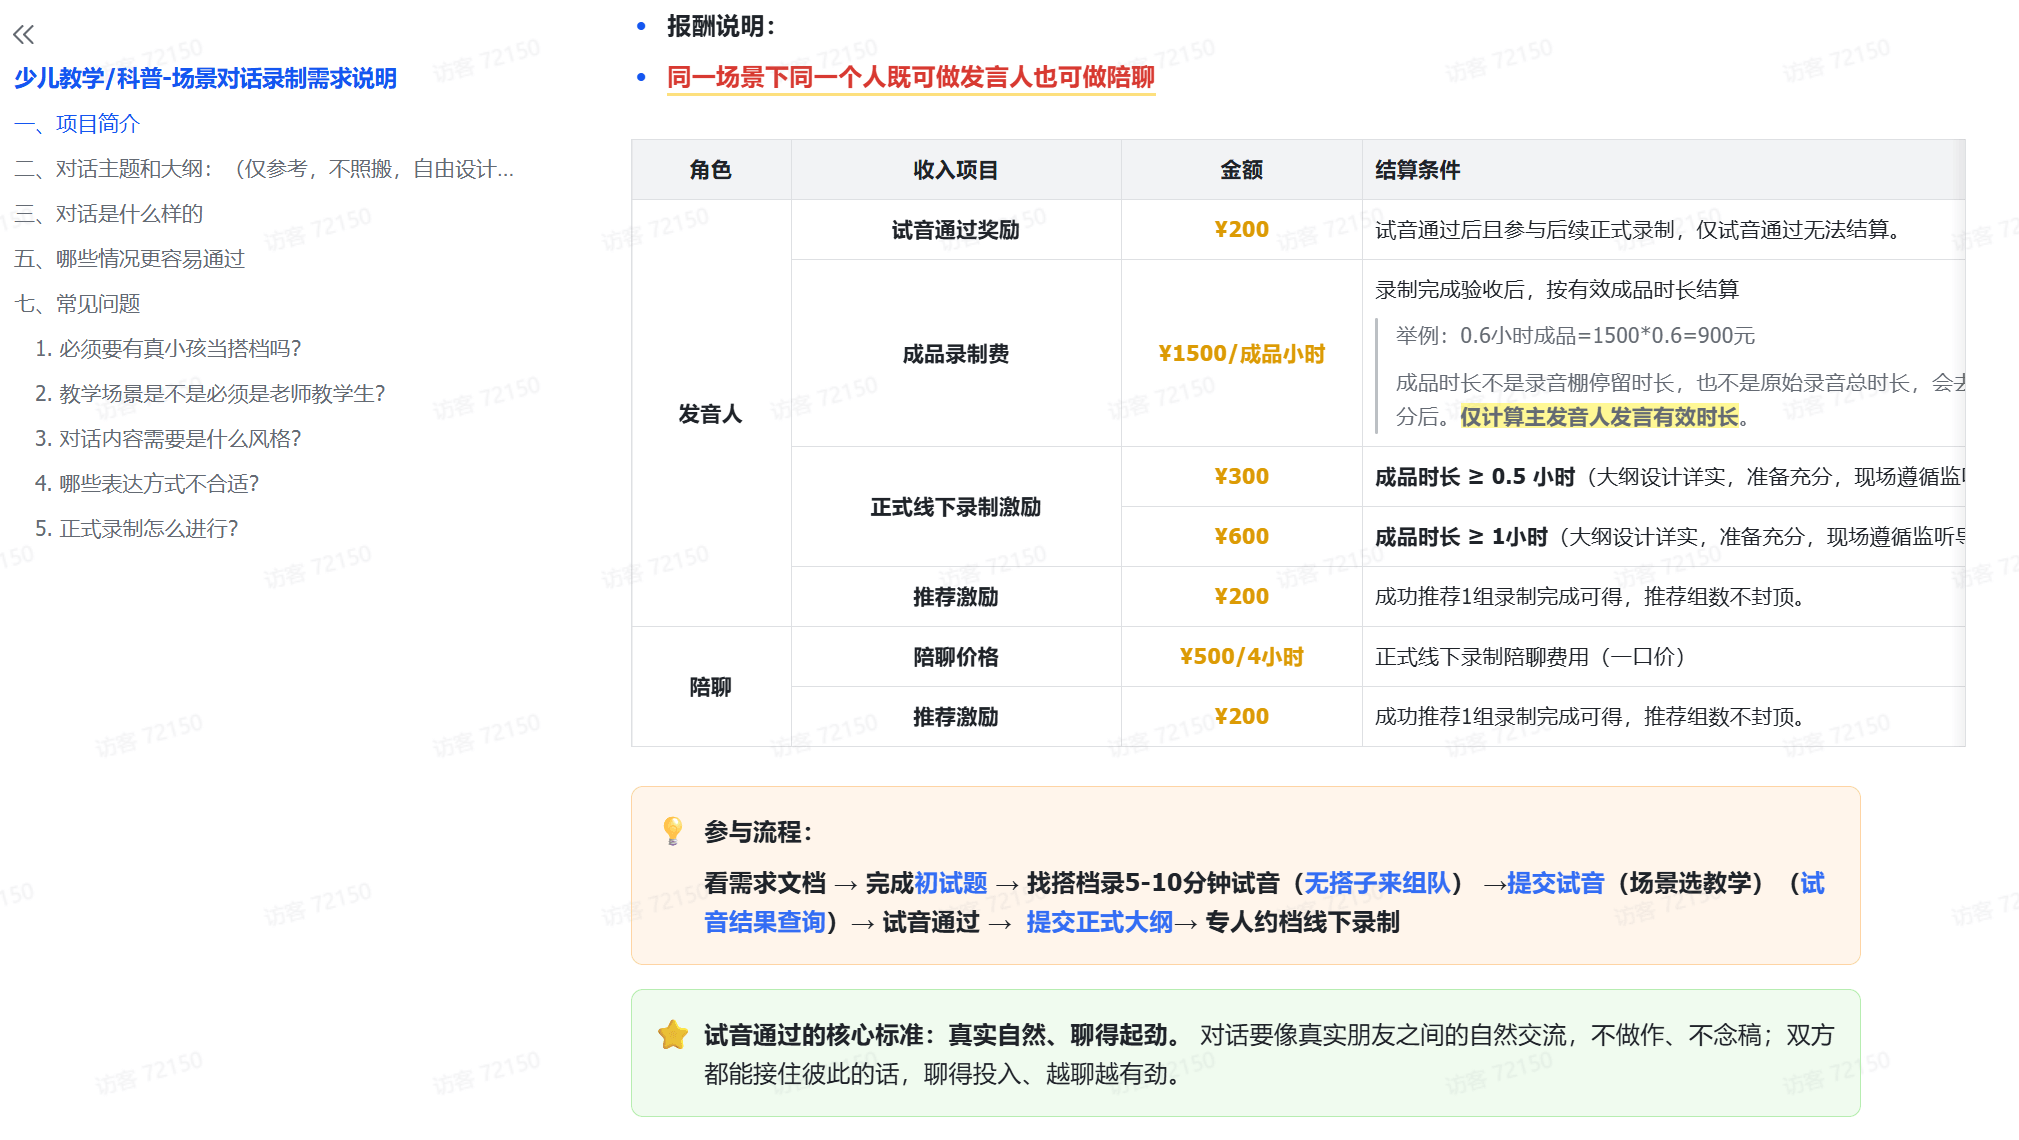
它的参与流程比一般任务细:先看需求文档、做完初试题,然后自己找搭档(没搭子的话平台也能帮忙配对),录一段 5 到 10 分钟的试音,场景选"教学"提交,等结果;试音过了,再交正式大纲,最后有专人约档期,去线下录音棚录。
而试音能不能过,标准就一条:真实自然、聊得起劲。对话得像是真朋友在聊天,不做作、不念稿,双方都能接住彼此的话,越聊越有劲。
这张单子其实把门槛说明白了:它要的不是"能说话的人”,是特定角色加特定经验,还得真能把天聊起来。
但先说清楚:这活儿没那么好赚
看到 1500 到 2500 元、甚至几百块一小时这样的数字,很容易心动。社交平台上还流传着一批招募卡片,标题写着"双人对话题制"“自然对话录音招募"“模拟辩论"之类,单价从几十到几千不等。
但这些数字背后,有两个特别容易被晃过去的坑。
一个是工时放大效应。在专业录音这行,想产出 1 小时合格的高质量有效对话,从前期对戏、反复重录,到后期剔废话、剪辑,实际往往得砸进去 8 到 20 个小时甚至更久。所以真正该看的"时薪”,是拿合格音频时长去除,而不是拿你在麦克风前坐着的时长。
另一个是高价任务的隐形门槛。标价 3000–5000 元/小时 的那批,一般要求播音主持的底子、配音演员的演技,或者能用特别自然的口吻把复杂情绪演活;普通小白够得着的,是闲聊类和基础 Agent 调优这类活,单价通常就几百甚至几十块(招募卡片里 50–100 元/小时 的一大把)。
举几个公开报道里的例子。字节从年初起就在北京大钟寺办公楼招素人为豆包大模型录音,两人一组、单次 3 小时(含 80 分钟自由聊天加 60 组带提示词对话),单次结 300 元,全程至少两名字节员工陪着;录音不清晰、吞字、情绪不够,都要重录,质量太差还会酌情扣钱。招聘平台上更常见的,是 BOSS 直聘 上 30–55 元/时 的 AI 录音兼职,内容就是"用普通话线上聊 2 小时、分 12 段录”。方言采集更轻,用本地方言跟豆包聊 20 轮、录屏,再给识别结果打分,40 元/人/任务。
不过,就算看到这儿还想试试,也得先知道:模兜不是注册了就能接单。流程大致是先注册、完善专业档案,再报名任务、签协议、参加线上培训,最后还要过一道 “试写考核”,不达标进不了正式作业;过了才能正式干活、交付,按小时或按天结算,打款到钱包提现。
平台不卡证书,但很看专业匹配度:医疗、法律这类任务会优先要有对应从业经历的人,所以报名不等于录取,光"试写"这一关就能刷掉一批。计费公开区间大约 56–1000 元/小时,整体比传统标注高一个量级,但门槛也确实高得多。
字节手里有抖音,为什么还要花钱"喂"数据?
抖音是国内最大的短视频平台,月活 10 亿上下,光每月新增的视频就 2.2 亿条,直播一场接一场,按这个体量,豆包要的"语料”,好像是现成的。
可真要细说,“平台手里有数据"和"这些数据能拿去训模型”,完全是两回事。
首先,短视频不是"对话"。抖音上的内容大多是单向的:口播、独白、带货、表演,一个人对着镜头说。而语音助手、Agent 这类产品最缺的,恰恰是多轮、真实、自然的双人对话:你一句我一句、有来有回。这种数据短视频里几乎淘不到,只能找人专门录,这也是为什么模兜的高价单,清一色是"双人搭档进录音棚"。
第二个,用户上传的内容,不是想用就能用。视频里的画面、声音、肖像,版权和人格权都攥在用户手里。按《个人信息保护法》和生成式 AI 的管理办法,拿用户内容训模型,得单独把"训练"这个用途讲清楚、再取得同意;最高法的相关意见更直接:没经同意拿别人的声音去训练,算侵害声音权益。所以平台真正要的,是"来源干净、可商用"的数据,这也是模兜任务里反复出现"保密协议"“可商用"的原因。
还有一点,抖音覆盖的是大众娱乐,缺专业人员。法律咨询、升学规划、模拟辩论、教学、方言,这些垂直、长尾的场景,短视频里又浅又散。模型想"会聊专业”,只能请真懂行的人来录。
所以大厂的处境其实是:存量的"野生"语料不缺,缺的是"可商用 + 专业场景 + 多轮对话"的增量数据。数据荒说的从来不是"没数据",是"能用的高质量数据"不够。有研究干脆预测,照现在的消耗速度,人类高质量的公开训练数据,可能撑不到 2030 年前后。
想通这一层,模兜为什么存在、那些单价为什么开得那么高,就大概知道原因了。
传统标注 vs 这波新玩法:新在哪
要弄明白"豆包喂养"到底新在哪,得先知道以前的传统玩法是怎么样的。
老一套:传统数据标注长什么样
数据标注这行其实一点都不新,说白了就是"教机器认世界":给图片拉框、把语音转成文字、给文本分类打标。这活儿上手是真快,但也真枯燥,早些年高中、中专学历就能干,一度被当成"数据车间"里的流水线工种。
代价就是单价被压得极低。有媒体梳理过一条曲线:2017 年的黄金期,一张简单的 2D 框还能有一毛多,甚至有人开到 5 毛;到了 2023 年,同样的活跌到 3–4 分钱,跌幅超过 90%。更难一点的 3D 点云框,也就 5 分一个。
落到人头上是什么概念?有湖南的标注员晒过结算单:一天拉 700 多个框、单价 4 分,到手 30.2 元。广东清远那边,计件每天 2000 个拉框大概 120 元,计时的话一天 100 元上下。整个行业看下来,传统标注公司月薪多在 3000–5000 元,兼职时薪 20–30 元,低的只有十几块。
管得也严。质检合格率普遍要 95% 以上,狠一点的公司卡到 98–99%,拉 100 个框,错 2 个,整张图就被打回返修。不少基地要求上班把手机锁进储物柜,鼠标轨迹、停留时间都被系统盯着,停超过三分钟就弹警告。
这几年它还被"基地化"了。国家数据局在全国布了 7 个数据标注基地:成都、沈阳、合肥、长沙、海口、保定、大同。拿大同来说,从业者里 94% 是本地户籍,带动了 3 万多人次就近就业。对不少县城青年和宝妈来说,这是家门口一份"坐办公室"的活;但说到底,还是实打实按件计酬的体力活。
行业里有句自嘲挺到位:“有多少人工,就有多少智能。”
这波新在哪
把传统和这波放一起对比,差别就清楚了:
| 维度 | 传统数据标注 | 这波新玩法(专家众包) |
|---|---|---|
| 典型任务 | 拉框、打标、语音转写、文本分类 | 专业场景双人对话录制(教学/法律/辩论/升学/角色扮演…)、方言语音数据、专业评测、数据采购 |
| 劳动性质 | 重复性体力活 | 认知劳动,要专业判断 |
| 门槛 | 早期高中/中专即可,现多要大专 | 主发音人要有真实专业经历(教师/律师/辩手等),陪聊不设限 |
| 计价 | 按件,几分到几毛/框 | 按小时或按场,专业对话录制单场 1500–5000 元 |
| 谁在发单 | 第三方标注公司、各地标注基地 | 大厂自建众包平台(模兜等) |
| 自动化风险 | 底层拉框正被 AI 替代 | 专家认知劳动暂难替代 |
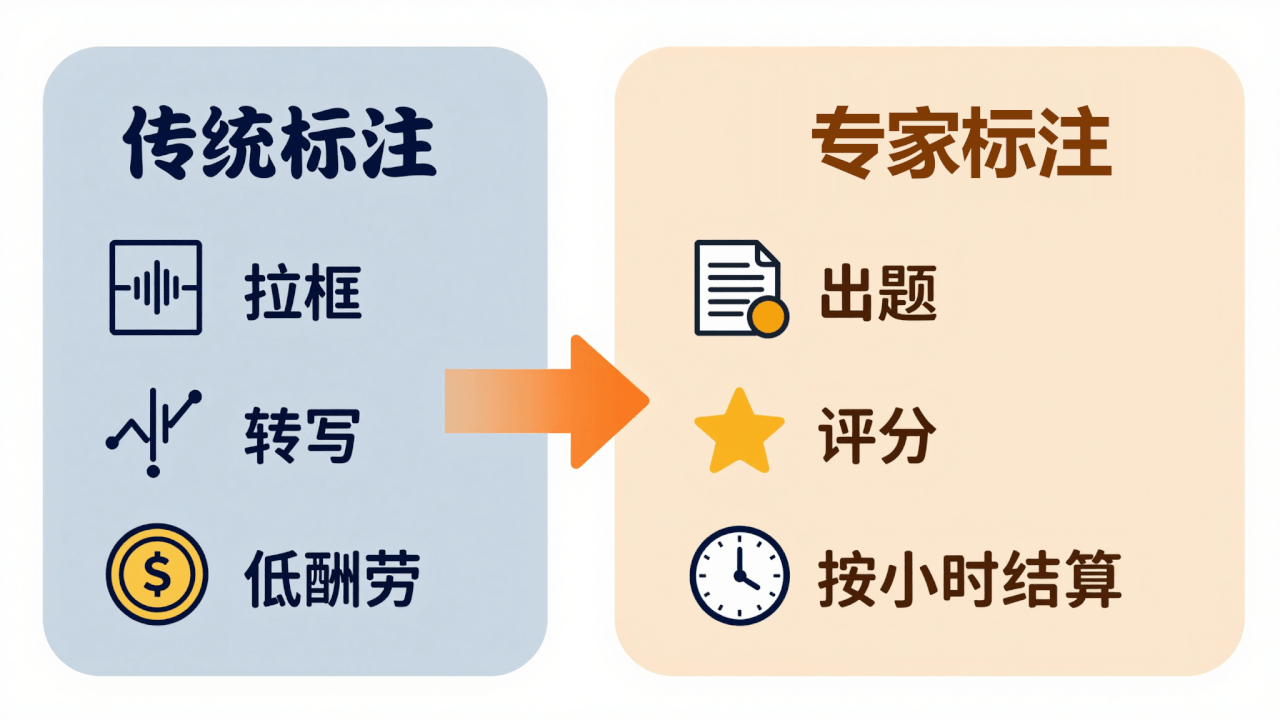
我自己的感受是,这里面真正变的不止一处。
最直观的是劳动性质:从"体力活"变成了"认知活",还带点表演成分。传统标注拼手速、拼耐心;这波拼的是专业判断和临场表达:教师得把知识讲明白、律师得懂实务、辩手真能辩,而且都得自然到不像在念稿。
然后是计价和门槛。按件变成了按小时或按场,拉框几分钱一个,专业对话录制单场能到 1500–5000 元。门槛也跟着变,但卡的不是"学校档次",而是"角色和专业经历",主发音人得有真实专业经历(教师、律师、辩手、升学顾问这类),陪聊那头反倒不设限。真要论学历线,这几年整体也在往上走:有从业者回忆,2016 到 2018 年中专学历就够,后来要大专,如今大模型标注普遍要本科、研究生。
还有一个容易被忽略的:底层正在被 AI 吃掉。简单的拉框打标,正被自动化标注工具快速替代;替代不了的,是"语义理解、价值判断"这类认知环节,也就是这波真正值钱的部分。
哪些领域、哪些人适合去试
有专业背景的,就走模兜这类专家平台,几个方向看着挺对口:教育(教师、讲师、幼教、教培从业者)对应教学、少儿科普这类双人对话录制;法律(执业律师、法务)对应法律咨询场景录制;升学规划(志愿填报、生涯规划顾问)和辩论(辩手、教练、评委)对应升学咨询、模拟辩论录制;语言(方言母语者、翻译、语言学爱好者)对应方言数据整理与语音采集;音乐(音乐相关专业)和表演(演员、配音)对应 AI 音乐评测、角色扮演情境模拟;医疗(医生)对应医生评估校验。
没有专业背景的,基本只能走传统标注那条线:在校及应届生、县域青年、宝妈、想找个灵活班的人。但得清醒:单价低、枯燥、成长有限,底层拉框还在被自动化挤压。当个过渡收入可以,别把它当天花板。
我的一点看法
普通人能靠它搞钱吗?
这波"豆包喂养"买的与其说是"劳动时长",不如说是你的真实专业经验。模兜上最贵的那批单子,要的不是"会说话的人",是"能把一段专业对话演真的人":教师得讲明白、律师得懂实务、辩手真能辩,还得自然到不像念稿,单场 1500 到 5000 元,买的就是这份经验。同一张单子里,主发音人卡专业经历、陪聊那头不设限,价格是按经验值不值钱分的,不是按你坐了多久。
坑也在这儿:工时放大效应,1 小时合格音频背后往往是 8 到 20 个小时,算账得拿"合格产出"去除。所以我的建议就一条:先掂量自己有没有一段能"演出来"的真经验。有硬专业(医疗、法律、教学、方言母语这些)的,去模兜跑几个周期短的任务试水,性价比是真不错;没有的话,边角活挣点零花可以,但别指望它撑起一份副业,那批高价单的门槛,比招募卡片看着的硬得多。
最后,就算你压根不打算接单,模兜也值得瞄一眼:它上面在招什么任务,大致就对应着大模型当下最缺哪类数据。抖音那样的存量语料堆成山,也补不上"多轮对话、专业场景、可商用"这几个窟窿。这是个不太需要内部消息、就能看到 AI 数据产业链怎么转的窗口。