EmbeddingGemma 2 最新体验:740M 参数把文、码、图、声、视装进同一个向量空间
10 月 6 日,Google DeepMind 发布了 EmbeddingGemma 2,一个开放权重的多模态嵌入模型。初代 EmbeddingGemma 只能处理文本,官方说发布一年多下载量已经超过 2000 万次;这一代直接把能力扩到了代码、图像、视频和音频,而且五种模态映射到的是同一个向量空间。
模型总参数 740M,基于 Gemma 4 架构,Apache 2.0 许可证;上下文窗口 8K(8192)tokens,是初代的 4 倍,默认输出 768 维向量,支持 100 多种语言。权重已经在 Hugging Face 和 Kaggle 上线。
核心亮点
一个模型干五件事。 文本、代码、图像、视频帧、音频,以前每种模态都要配一个专用嵌入模型,每个模型有自己的内存预算和推理链路。EmbeddingGemma 2 的思路是把它们统一到一个 768 维空间里:一段语音备忘录可以直接定位到视频里的某个片段,一张图片可以搜到语义相关的段落,代码和文档也能互相检索。
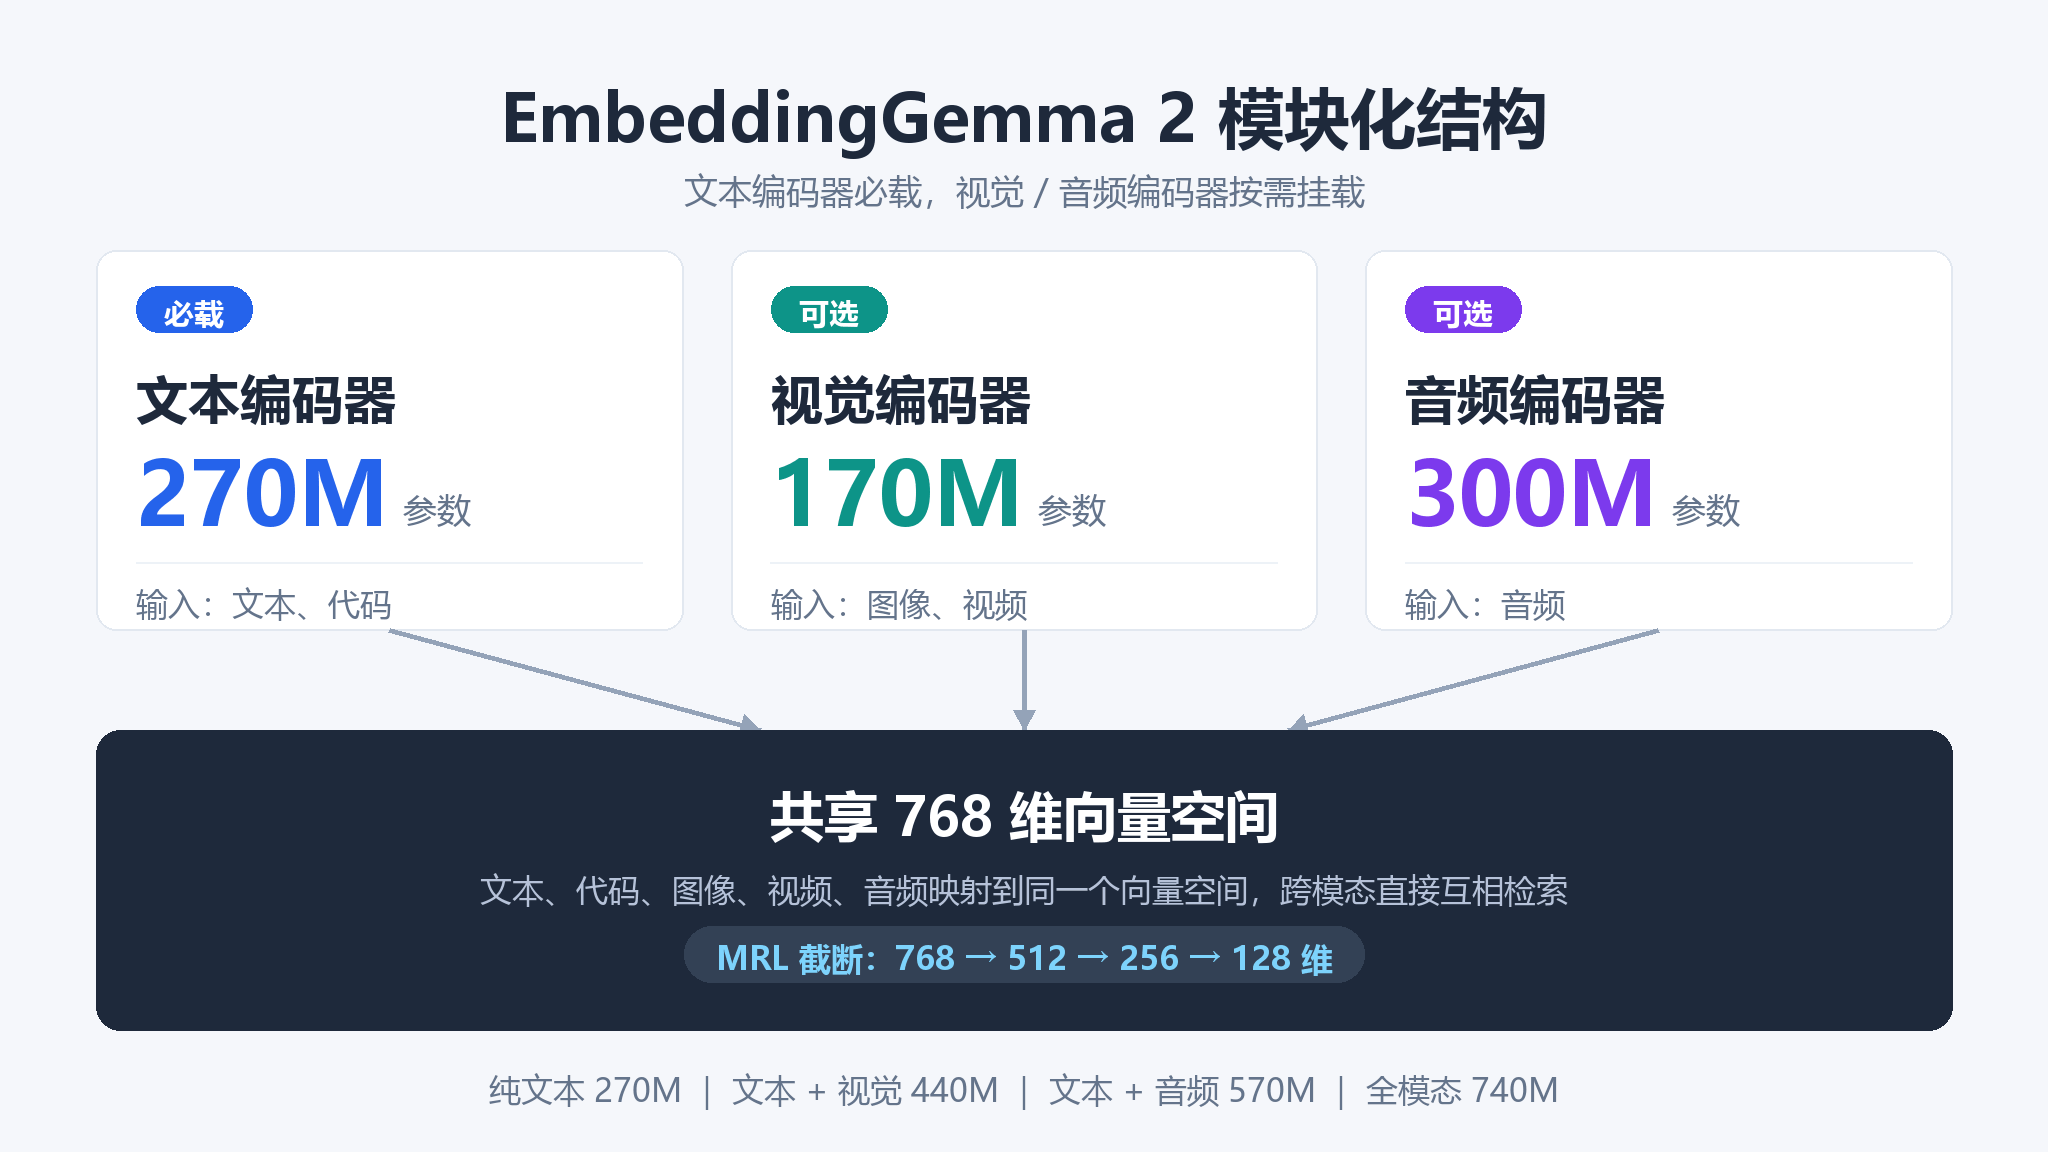
模块化设计,用多少加载多少。 740M 参数不是必须整体吃下:纯文本负载只需要 270M 参数的文本编码器,需要图像就再加 170M 参数的视觉编码器,需要音频就再加 300M 参数的音频编码器。做纯文本检索的应用,没必要为用不到的音视频模块付内存。
8K 上下文。 本地一次可以处理最长 5.5 分钟音频、29 张图像、58 个视频帧,或者这些内容的任意交错组合。对嵌入模型来说这个窗口算很宽,初代只有 2K。
MRL 截断。 模型用了 Matryoshka Representation Learning,输出向量可以从 768 维动态截到 512、256、128 维,本地向量库的存储和内存占用最高能降到原来的 1/6。截得越短损多少精度,要拿自己的语料测,官方没给通用阈值。
代码检索提升明显。 MTEB Code 从初代的 68.76 提到 78.68,涨了 9.92 分。Google 的说法是,在 sub-1B(10 亿参数以下)多模态嵌入模型里,它在 MTEB Code、MAEB 等基准上拿了领先分数,部分任务甚至超过参数量两倍于它的专用模型。注意,这些都是 Google 自己跑的分。
端侧内存:191MB 起步
Google 给了一台参考机器的数字:量化后跑在 Pixel 11 Pro 上,纯文本权重约占 191MB 活动内存,完整多模态模型约 567MB。作为参照,Ollama 上这个模型的 tag 从 270m(约 378MB)到 740m(约 1.3GB)不等,拉哪个 tag 基本就对应你要用哪部分能力。Google 开发者博客还给了个数字:MacBook M5 Pro 的 GPU 上,单张图片的视觉编码约 37.3ms。
这个内存量级意味着手机可以和其它端侧 AI 任务共存,整条检索管线不用上云。对数据不能出设备的场景,这是它相比云端嵌入 API 最实在的优势。
桌面端更宽松。这模型不吃 GPU,近几年任意一台笔记本靠 CPU 就能跑纯文本检索,整机 8GB 内存够用;带全模态的话 16GB、同时开着浏览器比较从容。llama.cpp 的 GGUF 动态量化最小 176MB,只有批量嵌入成千上万个文件时才值得上 GPU。另外 Ollama 要 0.36.0 以上才认这个模型,老版本先升一下。
Google 明确建议用
bfloat16或float32精度,不要用float16。自己部署的时候容易顺手选 fp16,这里留意一下。
使用方式
上手路径从低到高大概有三条,按官方文档列一下。
Ollama
发布当天 Ollama 就上了模型库。
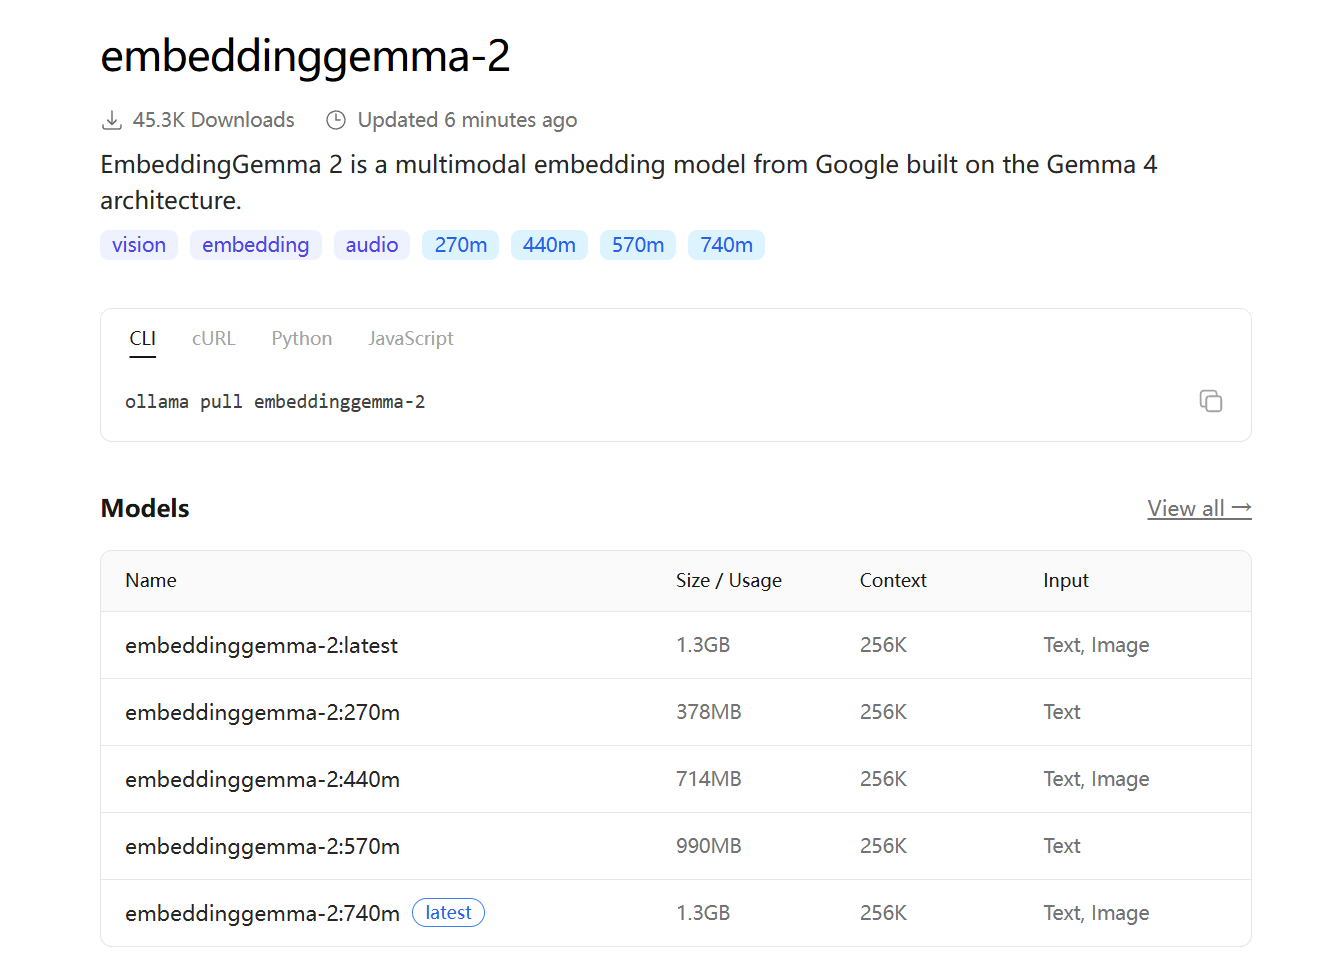
装好 Ollama 之后:
| |
本地接口是朴素的 REST,直接 POST:
| |
返回的就是 768 维向量数组。已经在用 Ollama 的人走这条最顺。
sentence-transformers
需要 sentence-transformers 6.1.0 及以上:
| |
| |
这里有个容易漏的点:prompt_name 不能省。查询用 SearchQuery,文档用 Document,两个用混了检索质量会掉。截断维度用 truncate_dim 参数:
| |
图像、音频的编码示例模型卡里都有,安装时把 [image,audio,video] 这些 extras 带上就不会缺依赖。
llama.cpp 和浏览器
GGUF 格式的权重由 ggml-org 和 Unsloth 提供,Unsloth 那版带动态量化:
| |
浏览器端可以走 transformers.js 加 WebGPU,Hugging Face 上放了 demo Space。服务端批量推理还有 vLLM、SGLang,Apple 生态有 MLX。向量存储可以配 Qdrant,微调 Unsloth 给了指南。
实际能拿来干什么
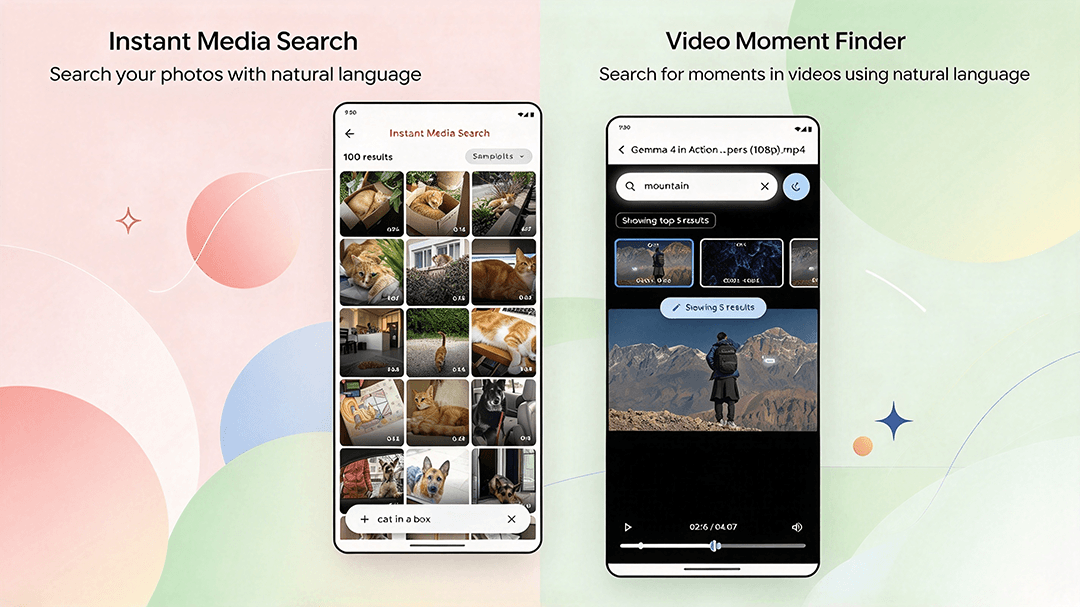
Google 自己在 AI Edge Gallery 里放了三个 demo,基本把典型场景演示全了:
- Instant Media Search:用一句话或一张图搜相册
- Video Moments Finder:用文本或音频定位视频片段
- Foresight:本地检索交给 EmbeddingGemma 2,推理交给 Gemma 4
最后一个值得多说两句。EmbeddingGemma 2 和 Gemma 4 共享文本分词器和音频编码器,两个模型可以在一条管线里跑,组合内存比各跑各的低一截。端侧 RAG 以前最大的问题是检索引擎和生成模型都要塞进手机,现在至少 Google 给了个自家生态内自洽的组合。
另外 MediaPipe 有个 Decision Task API,可以直接拿多模态上下文做分类、路由和预测,不用自己训东西。
基于它的开源应用:DigUp
模型之外,已经有人拿它做了完整应用。DigUp(github.com/ARahim3/DigUp,标语 “Describe it. Dig it up.")是一个免费开源的本地语义搜索工具,作者是 ARahim3。它干的事:用自然语言描述搜电脑里的文件,照片、PDF、文档、录音、视频都按内容匹配,而不是按文件名。底层正是 EmbeddingGemma 2,用的是 ggml-org 的 8-bit 量化权重,走 llama.cpp 推理,Mac 用 Metal,Windows/Linux 用 Vulkan。
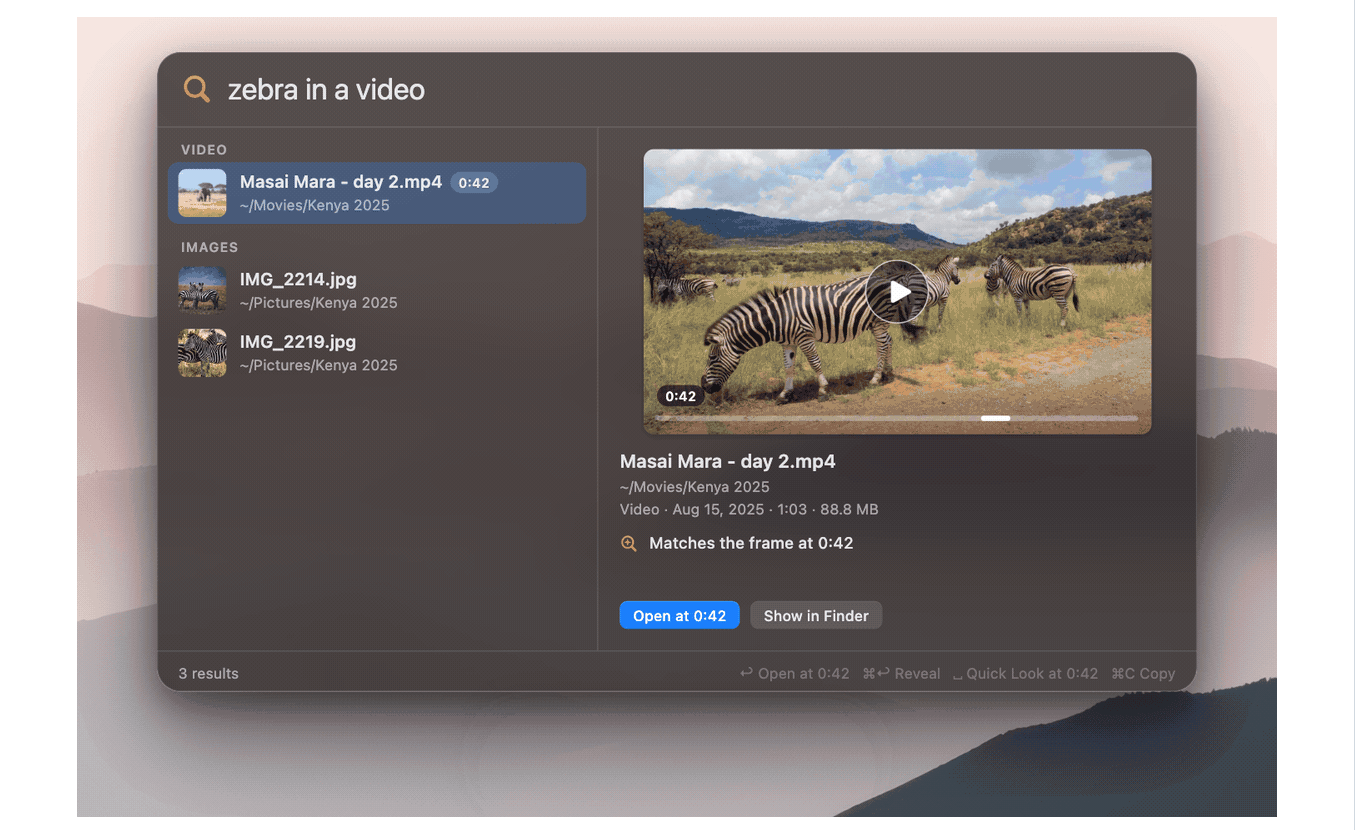
README 里几个例子很直观:
zebra in a video:直接打开斑马出现的视频片段the clause about pets in the lease:跳到租赁合同 PDF 里讲宠物的那一页payment declined error:找到对应的报错截图
发票号、错误码、姓名这类要精确匹配的场景,它另外做了原文加权,语义和精确字符串都沾。还有个可选的代码搜索(默认关闭),用 code: 前缀,比如 code: retry a failed call with backoff 能找到重试函数,不管它实际叫什么;code: refreshAccessToken 直达定义行,还能在 VS Code、JetBrains、Zed、Cursor 这些编辑器里打开到行。索引存在 SQLite 里,768 维向量加一份关键词索引,代码单独一份。
隐私是它主打的点:除首次下载模型(865MB)和每日更新检查之外不联网,无账户无遥测,只读文件,不改不移动不上传。首次全量扫描之后,新文件几秒内就能搜到,模型跑在独立辅助进程里,用完即退。
安装
Mac(Apple Silicon,macOS 14+)走 Homebrew 最省事:
| |
Windows(64 位 Win10/11)下 beta 安装包,免管理员,包没签名,Windows 提示的时候选 “More info → Run anyway”:
Linux(Ubuntu 22.04 / Debian 12+)有 .deb 和 AppImage,注意包名是 dig-up,Debian 仓库里已经有个无关的 digup 了:
| |
首次打开会先下模型(865MB,文本部分 310MB + 图像/音频编码器 555MB),然后选要索引的文件夹,会显示预估耗时。
使用
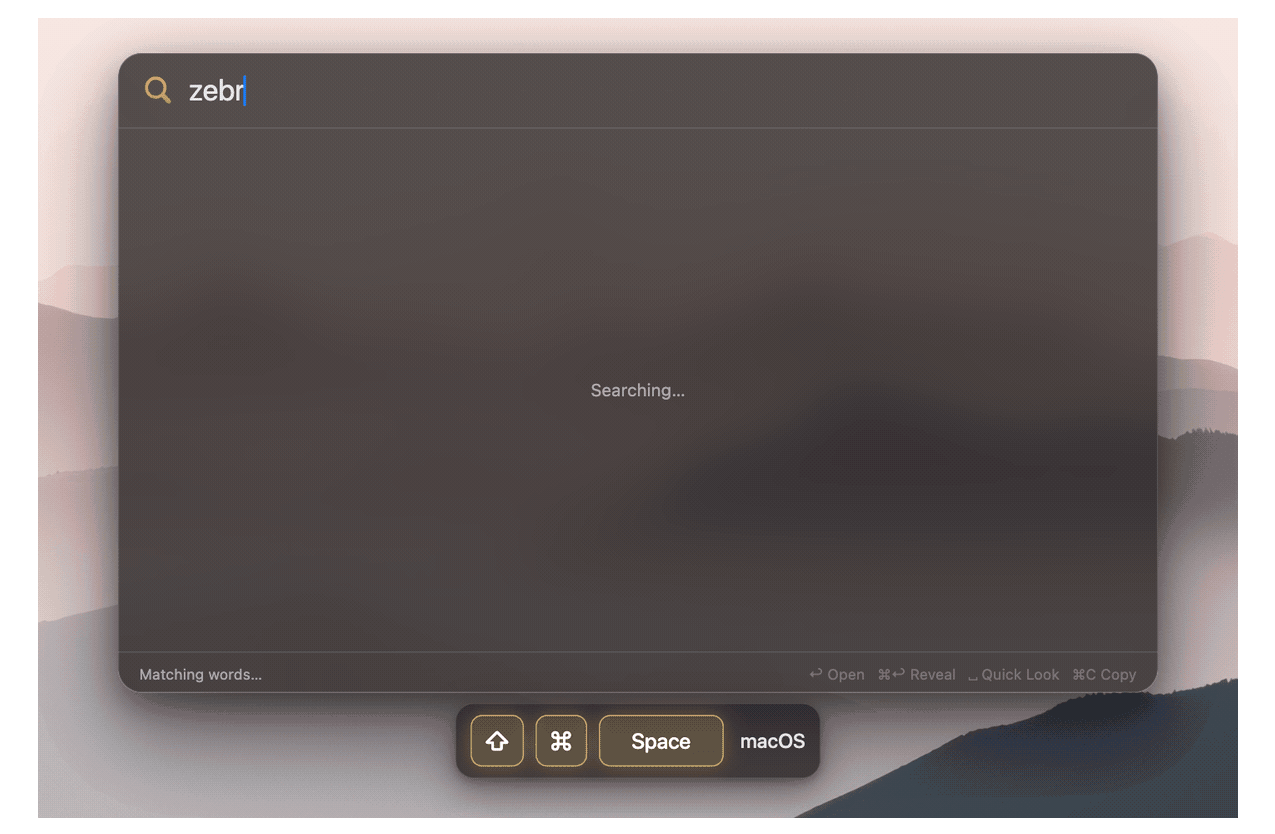
唤起快捷键 Mac 是 ⇧⌘Space,Windows/Linux 是 Ctrl+Shift+Space,都可以自定义。↓/↑ 在结果间移动,Enter 打开(PDF 到页、音视频到时刻、代码到行),Space 大图预览,⌘↩/Ctrl+Enter 在 Finder/资源管理器里显示。搜索窗口还能切到大窗口模式,图片网格加过滤器。
但是首次扫描很重,Mac 上几百个文件要几分钟,大的 Downloads 文件夹可能一小时往上;纯 CPU 处理一张图约几秒,作者拿 2017 款 Core i5 测的约 5 秒,所以安装时才让你先看预估时间。Windows/Linux 还是 beta(v0.7.0-beta.1),截图 OCR、旧版 .doc、RAW 照片、SVG 暂时只有 Mac 有。项目 MIT 许可。
当前值得尝试的方向
- 本地代码库索引。 MTEB Code 78.68 分,语义代码搜索、给 coding agent 做检索,都是立竿见影的场景
- 隐私优先的端侧 RAG。 数据不出设备,这点云端嵌入 API 没法比
- 跨模态媒体库。 录音、照片、视频混在一个库里的检索
总结
如果你在做移动或桌面端的本地检索、隐私优先的 RAG,或者给代码 agent 搭检索层,EmbeddingGemma 2 是目前少有的「一个模型全覆盖」选择。想最快感受效果,Mac 上 brew install --cask arahim3/tap/digup,用 DigUp 直接搜自己的文件,或者装个 Google AI Edge Gallery 玩那三个 demo;想接进自己的东西,Ollama 拉个 270m tag,半天就能验证思路。后面值得盯的是第三方基准复测和 Model Garden 上线,这两个落地之前,生产环境建议先小流量对照测试。
官方博客 https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/
Hugging Face 模型卡 https://huggingface.co/google/embeddinggemma-2
Ollama 模型库 https://ollama.com/library/embeddinggemma-2