RAG 的做法是把文档切成小段,用嵌入模型压成向量存进库。问题来了也压成向量,取库里最像的几段拼进提示词,让模型照着回答。找不找得到,全看向量离得近不近。
Zleap AI 放出来的 SAG2 反着走,整套系统跑起来只剩一个 SQLite 文件。没有嵌入模型,没有向量库,语料入库那一步一个模型都不调。11,656 段建完索引 2.36 秒,数据库 25.87 MiB,整个过程模型调用 0 次,花费 0 美元。
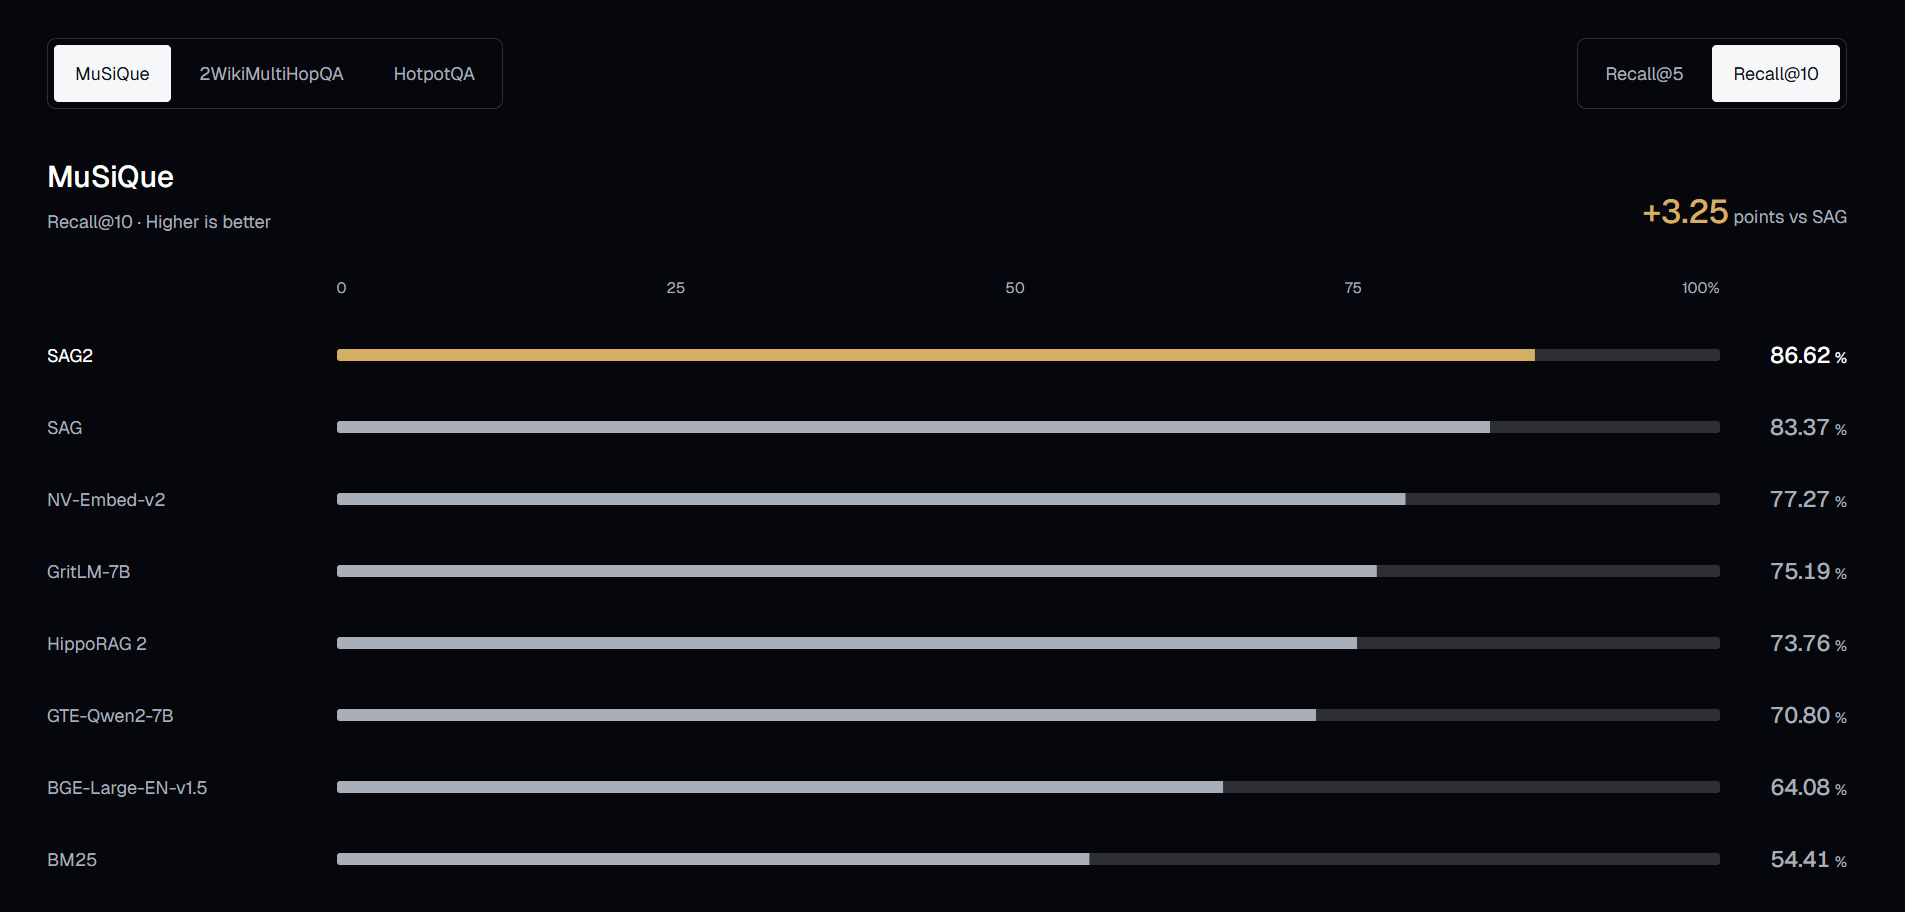
三个多跳基准各取 1,000 题,证据召回 R@10 分别是 86.62%、97.43%、99.00%。企业级那套有 511,962 篇源文档,R@10 是 81.10%,同一批题上纯 BM25 只有 68.4%,向量检索 46.0%。论文编号 2610.22588,仓库 MIT 开源在 github.com/Zleap-AI/SAG-Benchmark,分数能自己对一遍。这几个数里最不像话的是那个 2.36 秒。
普通 RAG 为什么找不全
MuSiQue 里有道题问埃里克·霍特出生在哪个县,答案不在任何一段原文里。一段告诉你他生在哪个镇,另一段告诉你那个镇属于哪个县。第一段跟问题还能对上几个词,第二段单看几乎不沾边,得先知道那个镇叫什么,它才有用。
稠密检索把每段编成一个向量,问题来了跟每段单独算一遍相似度,各排各的。第二段在那张榜上就是个普通条目,「A 指向 B」这层关系压根没进过它的计算。
GraphRAG、HippoRAG 2 和 LightRAG 选了另一条路,不靠相似度,靠提前把关系建出来。先让大模型把语料读一遍,抽出实体和关系连成图,查询的时候顺着图爬。多跳是能解决,可每进一批新文档都得重跑抽取,图跟语料一起长,也一起过期。
原版 SAG 往轻里做过一轮,MySQL 存事件和实体,Elasticsearch 存向量,BGE-Large-EN-v1.5 做嵌入,Qwen3.6-Flash 做抽取。比纯图谱轻,那几个组件还是得一个个装。它在 MuSiQue 上的 R@10 是 83.37%,SAG2 是 86.62%,涨了三个多点,省掉的正是这一整套。
reranker 那边还有一层天花板,再强也只能在候选池里挑,池子里没有的它捞不出来。
多跳那根线落到原文里,常常就是一个专名。问题问某个人,中间那段给出出生地,答案那段把出生地和县连起来,同一个词在两段里都出现。词法索引抓的就是这种重复,SAG2 敢把向量整条砍掉,靠的也是这个前提。
SAG2 是怎么找的
原文切成大约 2,200 个字符的片段,按词写进 SQLite 的 FTS5 全文索引,顺带记下来源、章节和词频。这一步只做分词,没有模型参与,2.36 秒跑完。
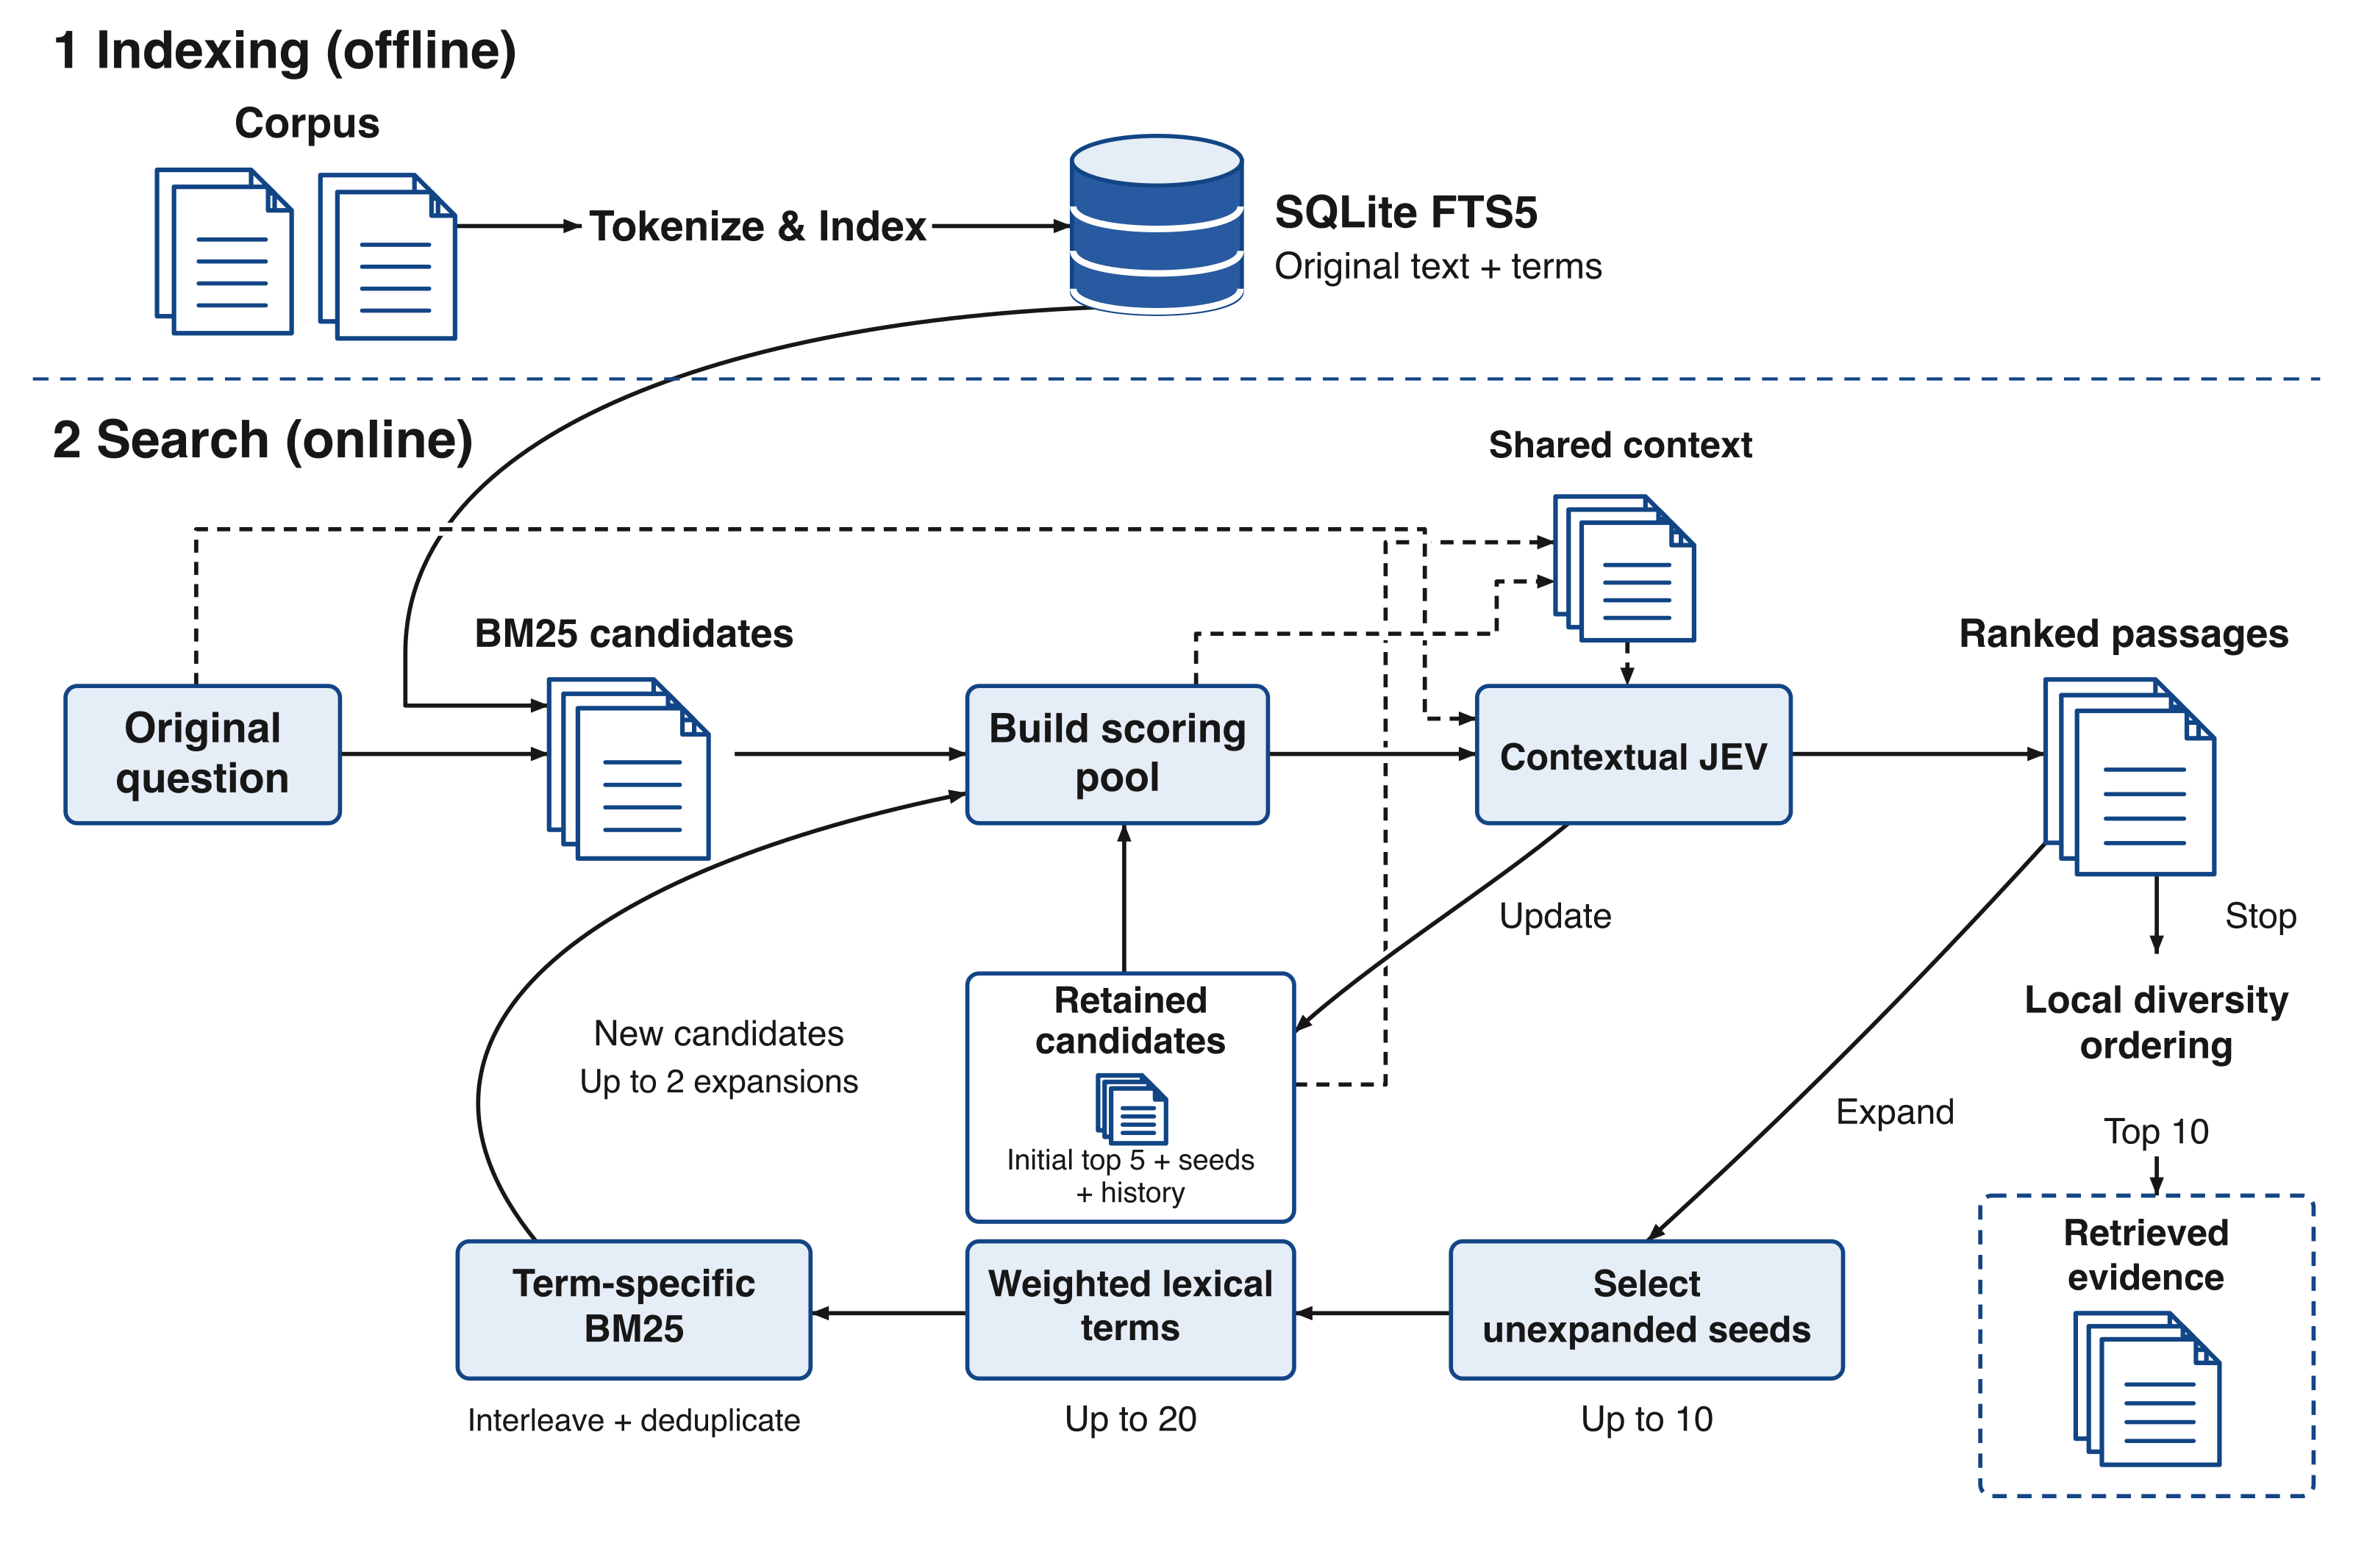
问题进来先走 BM25,捞出最多 100 个段落。接下来是这套架构里唯一用到模型的地方。Jev 是 TypeSafe 的判定模型,跟聊天模型不是一类,它不生成文字,只输出带概率的判定。这里问的是一句是非题,这段原文里有没有构成完整答案链所必需的事实,它回一个 0 到 1 的概率,表示「是」有多大可能。
在以往的方案里,这个位置要先用向量算一遍相似度,看这句话跟问题像不像,再抽一次实体关系,留给后面的检索导航。Jev 把这两个活合并了,而且它不产生推理 token,一次判定在百毫秒量级,所以一道题里问上几百次是划算的。默认配置下一道题最多 340 次段落判定。
打分完取排前面的 10 段当扩展起点,从这些段落的正文里挑词。挑词看四样东西,这个词在本段出现了几次,它在整个语料里有多稀有,它所在的句子有没有跟原问题共用的词,以及这段本身拿了多少分。合起来取前 20 个。
每个词单独去索引里查一遍,结果交错合并、去重,新捞到的段落回到打分那一步重来。默认走两轮,加上初始那轮,一道题最多三轮判定。
最后把排在前面的十条做一次多样性重排,让结果别都挤在同一个章节里。这一步纯本地计算,不发模型请求。
第一轮 Jev 只看见原问题。从第二轮开始,上下文里多了「我已经知道这些」,问的也变成「在已知这些的前提下,这段还缺不缺」。差别就在这一点上,把共享上下文去掉,R@10 从 86.62% 掉到 76.25%,只走一轮是 83.36%。反过来,把判断次数匹配到同一个量级,但不分轮、一次把候选池放大,只有 69.82%。判断次数花得一样多,带着上下文往前走能多拿将近 17 个点。
只需要一个 SQLite 文件
嵌入模型、向量数据库、抽取用的那轮 LLM 调用,一样都不需要,GPU 也没派上用场。装好之后索引就是一个文件,拷到另一台机器上直接能用。
成本挪到了查询时。Jev 按输入 token 计费,100 题 0.43 美元,1,000 题 4.33 美元,建库那一环是 0。查询延迟论文没单独报,只给了判断次数上限。
安装
Python 3.11 以上,加上 uv 和一个 C 编译器就够了。C 编译器是为了首次运行时编译 SQLite 的打分扩展,Windows 上对应 MSVC Build Tools。Docker、MySQL 和 Elasticsearch 这些都不用装,GPU 也不需要。
| |
然后在 sag2/ 目录下配好 .env,Jev 走 OpenRouter 的接口。
| |
这里仓库默认填的是 OpenRouter 的 alpha 通道。Jev 官方地址是 https://api.typesafe.ai/v1/systemone,但如果出口 IP 落在它不服务的地区,请求会直接返回 451,换回 OpenRouter 或者走代理都行。
使用
建索引
| |
它会下载缺的数据文件,把三个数据集的索引都建好,全程不请求模型。索引默认落在 .cache/sag2/,终端会打印每个数据集的原文数、索引片段数和题数。
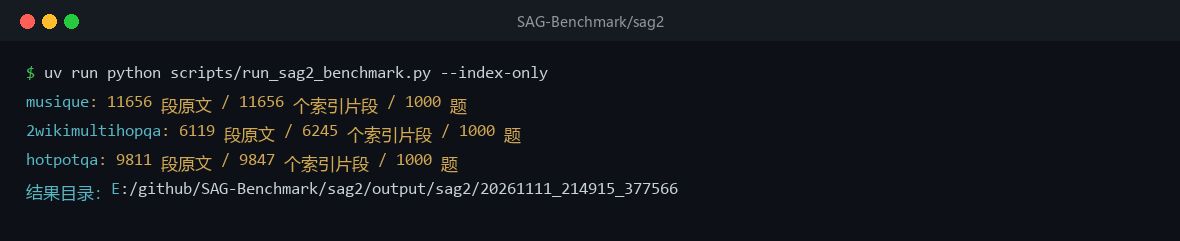
脚本默认直接连 huggingface.co 拉数据,国内会很慢。可以先把那六个文件从 hf-mirror.com 下好丢进 sag2/dataset/,再单独跑 --index-only,它会跳过已经存在的文件。
跑十道题试试
索引建完,拿十道题试一下水。
| |
到这一步才开始产生 Jev 的费用。--limit 只限制评测的题数,检索仍然覆盖完整语料,所以这十道题的召回率有参考价值。跑完终端会打 Recall,逐题结果在 output/sag2/musique-smoke/musique/details.jsonl,汇总在旁边的 metrics.json。
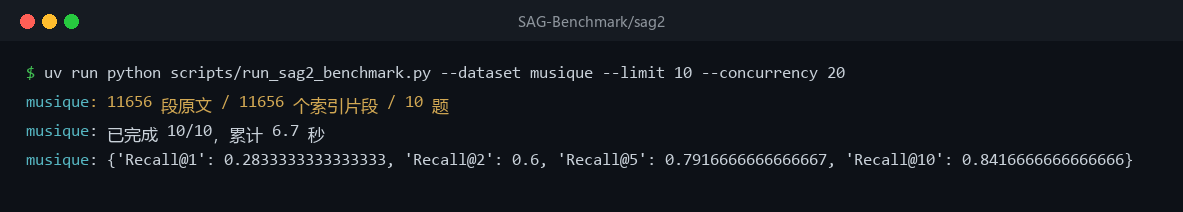
我这十道题的 R@10 是 84.2%,同一批题上纯 BM25 是 43.3%。论文的 1,000 题全量是 86.62%,十道题只差两个多点。metrics.json 里还记了单题平均耗时 5.3 秒和 99 万输入 token,按 TypeSafe 的价目算下来十题四美分出头,跟论文给的一百题 0.43 美元对得上。
全量跑和几个关键参数
| |
search_results.json 存每题最终选中的原文,喂给后面的问答环节直接能用。bm25_results.json 存的是同一题的纯 BM25 结果,想知道扩展到底贡献了多少,拿这两个比一下。config.json 记了模型和参数,还有数据与代码的校验值,过一阵子回头看也知道当时跑的是什么条件。
--candidate-k 控制每轮候选数,默认 100,--seed-k 是扩展起点数,默认 10,这两个一般不用碰。--expansions 决定追加几轮检索,默认 2,能设 0、1、2。切片长度归 --chunk-chars 管,默认 2200。
--mode 除了默认的 sag2,还有两个值。agentic 把 SAG2 交给一个 LLM 当工具调用,让它自己决定下一步查什么,MuSiQue 的 R@5 从 80.68% 涨到 92.20%,代价是每道题多几次大模型调用。local 用本地的 Qwen3-Reranker 或 Jina 顶替 Jev,能完全离线跑,但 MuSiQue 的 R@10 只有 72.13%,跟 Jev 的 86.62% 差得比较远。
企业级那个数据集走独立入口。build_enterprise_index.py 先建库,run_enterprise.py 只读索引跑 470 道题,分两步是为了别重复建。
手上的语料想接进去,目前只有一个入口 scripts/search_local.py。语料整理成一个 JSON 数组,每项给 title 和 text 两个字段,索引会按内容指纹建在 --cache-dir 底下。这个入口走的是本地重排模式,不请求 Jev,想用 Jev 打分得自己换掉脚本里的 scorer。公开的评测入口只认那四个数据集。
现在还不行的地方
整套架构里需要外部服务的只有 Jev 这一个环节,而它偏偏是决定检索成败的那一环。只能走托管 API,模型架构和参数量没公开,权重也拿不到。索引可以留在本地,但问题和候选段落的原文要发出去。数据不许出内网的场景,这套现在用不了。
改写和别名这类,BM25 天生抓不到。一个说法绕了几道弯才落到答案上,同样是它的盲区。MuSiQue 那 166 道四跳题的实测结果里,十段中能把全部证据找齐的只有 28.31%,两跳题是 87.07%。跳数越多越吃力。
论文只评了检索,没评答案生成。SAG2 现在的入口返回证据,原 SAG 那套问答和 LLM Judge 流程没有跟过来。MuSiQue 在方法开发期间被用过,分数里有多少是调出来的,论文自己也把这条列进了有效性威胁。
要不要试
手上的语料经常在变,又不想为了检索去维护一套向量库和抽取流水线,这套东西值得花半天试试。反过来,语料一年半载不动一次,现有的向量检索也跑得挺好,就没什么换的必要。向量库的编码是一次性的,摊到每次查询上几乎为零。SAG2 每问一次都要调 Jev,这笔钱是持续的。为了省一次建库的时间,不划算。
企业里做 RAG,资料大多是保密的,公司要是明确规定数据不许出内网,这套就先别试。它判断的那一环跑在别人服务器上,你的问题和检索出来的原文都得发过去,本地能留住的只有一个索引文件。
还有一种情况得提前知道。用户问的和文档里写的对不上词的时候,比如问「裁员」而文档里写的是「人员优化」,词法索引接不上这根线。多跳题它能补,换个说法问的题它补不了。
真要试,第一步跑 --index-only。这一步不要 key,也不产生费用,只是把语料切片写进索引。切片数和题数对得上,再拿十道题跑一次,花几毛钱。跑完把 search_results.json 和 bm25_results.json 对着看,前者是 SAG2 挑出来的段落,后者是同一批题上纯 BM25 挑的。